Un prospect, dix façons de l’écrire : le vrai problème de qualité des données #
La présence de doublons est un des problèmes les plus présents des CRM.
Lorsque les équipes de vente remplissent manuellement les informations, il est fréquent de rater la présence d’un prospect et de le recréer avec des informations légèrement différentes.
Par exemple, la Société Générale peut facilement être aussi renseignée sous les formes Sté Générale ou SOCIETE GENERALE SA.
Sans réconciliation, les équipes commerciales démarchent le même prospect deux fois, les informations terrain sont réparties sur différents comptes, et le scoring client devient inexploitable.
Cette problématique se retrouve également dans les systèmes qui tentent de relier entre elles des bases de données créées indépendamment : CRM, référentiel fournisseurs, base de facturation. Sans identifiant commun, la reconnaissance du même fournisseur dans les différentes bases devient impossible.
Transparence Santé en est un exemple frappant : ce registre officiel, où les entreprises pharmaceutiques déclarent les montants versés à des associations et des professionnels de santé, laisse une grande liberté aux laboratoires pharmaceutiques sur la manière de renseigner leurs bénéficiaires. Le résultat final est alors une base qui est un regroupement d’un millier de bases qui ont certes les mêmes colonnes mais possèdent leurs propres conventions.
L’utilisation des identifiants nationaux (SIREN pour les entreprises, RNA pour les associations, RPPS pour les professionnels de santé) peut alors être la solution. Peut importe le nom attribué à un bénéficiaire, l’utilisation d’un identifiant national permet de cibler sans ambiguité une entité. Malheureusement 50 % des déclarations qui concernent des personnes morales (associations comme entreprises) n’ont aucun identifiant. Ce n’est pas un problème d’accès à l’identifiant, c’est un choix de déclaration. Les comptables des laboratoires ne valideraient probablement pas un virement sans avoir un SIREN.
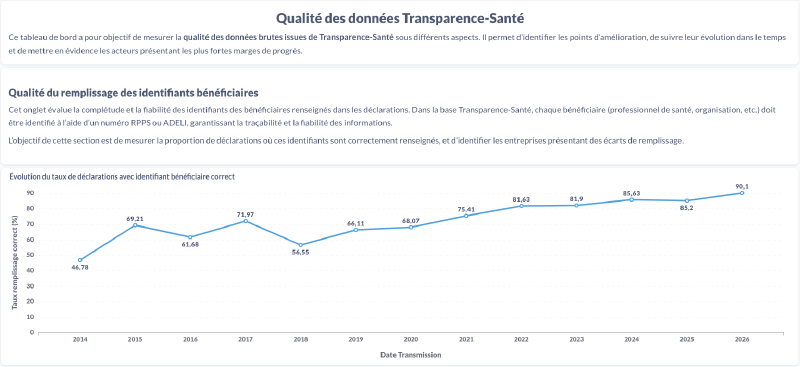
Les utilisateurs de la base Transparence Santé, souvent des journalistes sans formation data, se retrouvent donc avec une base de données peu exploitable. Ce problème dépasse largement ce cas spécifique : sans solution de déduplication, toute organisation fait face aux mêmes conséquences. Pour identifier toutes les déclarations d’une même entité, il faut retrouver manuellement toutes les variations de son nom, source d’erreurs significatives et de perte de confiance dans les données. Les impacts sont alors doubles : des surcoûts opérationnels liés au temps passé à identifier manuellement les doublons, et une perte de fiabilité des données due au démarchage en double, aux informations clients dispersées sur différents comptes, et aux analyses faussées par des incohérences.
Euros for Docs s’attaque à ce problème. L’association a mis en place tout un système de traitement de la base Transparence Santé pour regrouper les variantes d’une même entité et permettre une analyse fiable des risques de conflit d’intérêt.
Retrouver les doublons de professionnels de santé est relativement simple. On peut retrouver ou corriger le numéro RPPS en utilisant des informations secondaires (profession, code postal) renseignées par les laboratoires.
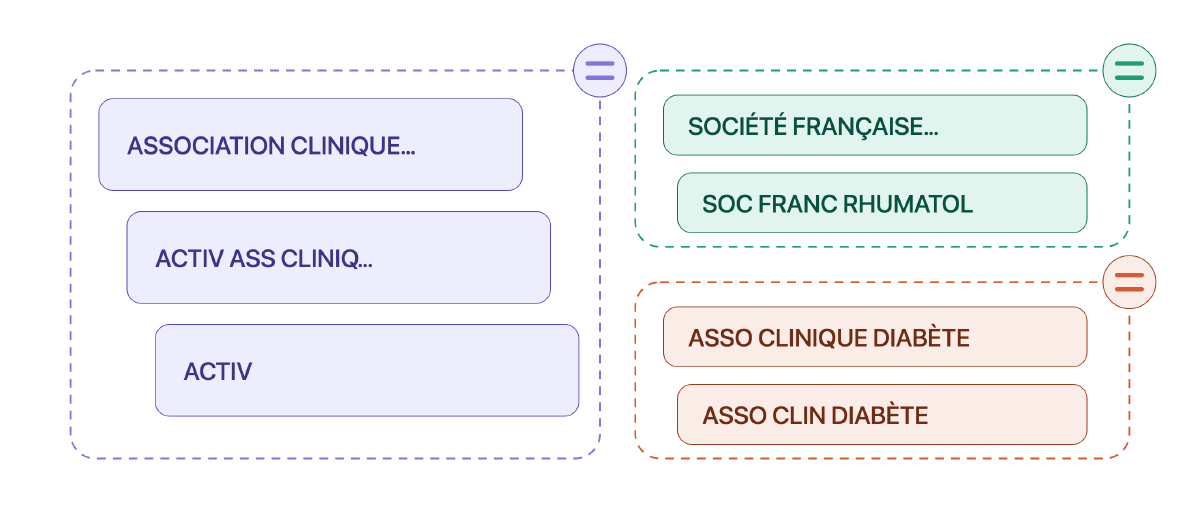
Pour les personnes morales, seul le nom déclaré par le laboratoire est disponible, sans format ni convention imposée. L’association ACTIV, par exemple, apparaît sous trois formes dans la base :
ASSOCIATION CLINIQUE ET THÉRAPEUTIQUE INFANTILE DU VAL DE MARNE (ACTIV)
ACTIV ASS CLINIQ THERAP INFANTIL
ACTIV
Un humain reconnaît immédiatement la même entité. Mais les chaînes de caractères sont techniquement différentes. La suite de cet article explore différentes manières de comparer ces noms pour que les variantes d’une même entité soient considérées suffisamment proches entre elles (et différentes de variantes d’autres associations) pour être considérées comme doublon.
Des noms si proches mais si différents #
Avec des dizaines de milliers de déclarations, la déduplication manuelle est irréaliste. Sans automatisation, une exposition à des coûts opérationnels élevés et à une dégradation de la qualité des données est inévitable, ce qui impacte directement les analyses et les prises de décision. Il est donc nécessaire de trouver une représentation mathématique des noms d’associations qui permet de prendre en compte les variantes les plus fréquentes (sigles, abréviations phonétiques voire des fautes de frappe) et considérer les variantes comme similaires malgré leur apparente différence.
Les métriques de similarité #
Pour automatiser la détection des doublons, plusieurs approches existent. En voici les principales, avec leurs forces et leurs limites.
Comparaison caractère par caractère #
La distance de Levenshtein compte le nombre de modifications (ajout, suppression, remplacement de lettre) nécessaires pour passer d’un nom à un autre. Cette approche est particulièrement efficace pour détecter les fautes de frappe, comme Société écrit Socité.
Cependant, elle atteint rapidement ses limites avec des variantes plus complexes. Dans notre base, le nom complet de l’ACTIV est ainsi jugé plus proche de l’association sur le diabète (41 modifications) que de son propre acronyme ACTIV (58 modifications). Comme un correcteur orthographique qui compte le nombre de touches à changer, cette méthode reste trop sensible aux différences de longueur.
| Nombre de modifications | nom complet | ACTIV ASS CLINIQ THERAP | ACTIV | ASSO CLINIQUE SUR LE DIABÈTE |
|---|---|---|---|---|
| nom complet | - | 39 | 58 | 41 |
| ACTIV ASS CLINIQ THERAP | - | 27 | 22 | |
| ACTIV | - | 25 |
Comparaison intelligente #
La distance de Jaro-Winkler améliore la détection en tenant compte de l’ordre des lettres similaires dans la chaîne et en accordant un bonus aux noms qui commencent de la même façon.
| nom complet | ACTIV ASS CLINIQ THERAP INFANTIL | ACTIV | ASSO CLINIQUE SUR LE DIABÈTE | |
|---|---|---|---|---|
| nom complet | - | 68% | 53.8% | 64.3% |
| ACTIV ASS CLINIQ THERAP INFANTIL | - | 71.9% | 61.7% | |
| ACTIV | - | 56.9% |
Levenshtein et Jaro-Winkler partagent la même limite : elles comparent les chaînes caractère par caractère, sans tenir compte de l’importance des termes. Par exemple, ASSOCIATION apparaît dans des centaines de noms différents, mais contribue autant dans la similarité que THERAPIE ou VAL DE MARNE, pourtant bien plus discriminants.
Vers des approches plus intelligentes #
Pour aller plus loin, il faut donner plus de poids aux mots rares et distinctifs comme ACTIV ou CARDIOLOGIE, et moins aux mots courants comme ASSOCIATION ou française. Les méthodes suivantes utilisent cette idée, mais avec des approches différentes.
Pondération par rareté des mots #
Le TF-IDF attribue un score à chaque mot en fonction de sa fréquence dans l’ensemble du corpus. Un terme présent dans 70 % des noms, comme ASSOCIATION, reçoit un poids faible, tandis qu’un terme rare comme ACTIV en reçoit un élevé.
Sur notre base Transparence Santé, cela donne par exemple :
| Terme | Fréquence dans le corpus | Poids |
|---|---|---|
| ASSOCIATION | 60 239 | très faible |
| FRANCAISE | 8 739 | faible |
| CARDIOLOGIE | 2 29 | élevé |
| ACTIV | 72 | très élevé |
Cette approche règle le problème des préfixes génériques : deux associations qui partagent seulement CLINIQUE ne sont plus jugées similaires. À l’inverse, l’acronyme simple ACTIV a une similarité de 45 % avec son nom complet.
| nom complet | ACTIV ASS CLINIQ THERAP INFANTIL | ACTIV | ASSO CLINIQUE SUR LE DIABÈTE | |
|---|---|---|---|---|
| nom complet | - | 0% | 0% | 7.7% |
| ACTIV ASS CLINIQ THERAP INFANTIL | - | 45.2% | 0% | |
| ACTIV | - | 0% |
Cependant, la méthode reste limitée face aux abréviations : CLINIQ et CLINIQUE sont deux mots distincts, et comme montré dans la dernière colonne, l’association sur le diabète a une similarité de 0 % avec deux variantes de l’ACTIV car aucun mot ne correspond.
Comme un moteur de recherche qui donne plus de poids aux mots uniques de votre requête, cette méthode est plus fine, mais pas parfaite.
Analyse par morceaux de mots #
Les shingles contournent ce problème en ne travaillant plus sur les mots mais sur les suites de caractères. Chaque nom est découpé en trigrammes, des suites de trois lettres consécutives.
Prenons l’exemple de l’ASSOCIATION CLINIQUE ET THÉRAPEUTIQUE INFANTILE DU VAL DE MARNE et de sa variante abrégée ACTIV ASS CLINIQ THERAP INFANTIL :
ASSOCIATION CLINIQUE ET THÉRAPEUTIQUE INFANTILE DU VAL DE MARNE
→ trigrammes: [ass, soc, oci, iat, ati, tio, ion, cli, lin, ini, niq, iqu, que, ... , mar, arn, rne]

ACTIV ASS CLINIQ THERAP INFANTIL
→ trigrammes: [act, cti, tiv, ass, cli, lin, ini, niq, ..., inf, nfa, fan, ant, nti, til]

Communs : ass, soc, cli, lin, ini, niq, the, rap, ape, inf, nfa, fan, ant, nti, til
Les trigrammes communs comme ass, soc, cli, lin, ini, niq, the, rap permettent de reconnaître que ces deux noms se rapportent à la même entité, même si les mots complets sont différents.
Alors que le TF-IDF sur les mots entiers ne trouve aucun mot commun entre l’ASSOCIATION CLINIQUE ET THÉRAPEUTIQUE DU VAL DE MARNE et ACTIV ASS CLINIQ VAL MARNE et conclut à une similarité nulle, les shingles, eux, retrouvent les trigrammes de ACTIV dans les deux variantes, de ASS et CLINIQ dans ASSOCIATION CLINIQUE, et de VAL MARNE dans les deux versions. Cette granularité fine leur permet d’identifier une similarité entre les deux variantes, là où le TF-IDF échouait complètement.
| nom complet | ACTIV ASS CLINIQ THERAP INFANTIL | ACTIV | ASSO CLINIQUE SUR LE DIABÈTE | |
|---|---|---|---|---|
| nom complet | - | 42.4% | 0% | 40.2% |
| ACTIV ASS CLINIQ THERAP INFANTIL | - | 40.1% | 33.6% | |
| ACTIV | - | 0% |
Comme un puzzle où les pièces communes permettent de reconnaître qu’ils vont ensemble, cette méthode est particulièrement efficace pour les abréviations.
Compréhension du sens #
Le TF-IDF sur shingles couvre les abréviations et fautes de frappe, mais reste aveugle à la sémantique : cœur et cardiologie produisent des trigrammes entièrement différents, et leur similarité sera nulle malgré leur proximité de sens.
La méthode Doc2Vec va plus loin : elle comprend le sens des mots, pas juste leur orthographe. Cœur et cardiologie sont ainsi reconnus comme similaires, même s’ils n’ont aucun trigramme en commun. Comme un traducteur qui comprend que voiture et automobile veulent dire la même chose, cette approche capte les relations sémantiques.
En pratique, Doc2Vec et TF-IDF+shingles sont complémentaires : l’un capte la similarité morphologique (les abréviations), l’autre la similarité sémantique (le sens).
Conclusion #
Levenshtein et Jaro-Winkler fonctionnent bien pour des noms propres de personnes, où les variations sont faibles et prévisibles. Pour des noms d’associations, elles échouent : le même préfixe générique peut dominer le score et masquer des différences réelles, ou au contraire une abréviation peut rendre deux variantes du même nom méconnaissables.
Le TF-IDF sur shingles de caractères règle la majorité de ces cas : il pondère les termes par leur rareté et traite les abréviations morphologiquement proches comme équivalentes. Doc2Vec ajoute une couche sémantique, utile quand les formes divergent trop pour partager des n-grammes.
Pour choisir la bonne approche selon votre problème, voici un guide pratique :
| Votre problème | Méthode recommandée | Quand éviter ? |
|---|---|---|
| Fautes de frappe | Levenshtein / Jaro-Winkler | Abréviations, mots génériques |
| Mots distinctifs | TF-IDF | Abréviations |
| Abréviations | Shingles | Sémantique |
| Sémantique | Doc2Vec | Abréviations pures |
Aucune de ces métriques n’est parfaite prise isolément. C’est pourquoi EuroForDocs les combine toutes dans un modèle entraîné sur des paires annotées manuellement. Le modèle produit un score de probabilité de doublon pour chaque paire de bénéficiaires, permettant une réduction significative des coûts opérationnels et une amélioration de la fiabilité des données.
Un prochain article détaillera comment le machine learning permet de toutes les utiliser en même temps pour scorer automatiquement la similarité entre les noms.